
過去データを活用した子部品の選択組立手法の開発
大久保叡一,川口明敬
大久保 叡一 高度情報マネジメント統括本部AI変革推進部
川口 明敬 高度情報マネジメント統括本部AI変革推進部 主査
製造業における製品の組立工程では,子部品の形状や特性の軽微なばらつきが組立後の品質に影響を及ぼすことがある.本稿では,過去データを学習した機械学習モデルにより子部品組合せの不合格確率を予測し,ハンガリアン法を用いて最適な組合せを探索する手法を提案する.シミュレーションにより,ランダムなマッチングと比較して欠陥率を低減し,製造効率・信頼性の向上に有効である可能性を示した.
In the assembly process of products in the manufacturing industry, slight variations in subcomponents can sometimes affect the quality after assembly. In this paper, we propose a method that predicts the probability of failure for subcomponent combinations using a machine learning model trained on historical data, and searches for the optimal combinations using the Hungarian algorithm. Through simulations, we demonstrated that the proposed method can reduce the defect rate compared to random matching, suggesting its potential effectiveness for improving manufacturing efficiency and reliability.
1. 緒言
IHIグループの製品の多くは,複数の子部品から構成されている.昨今,製品に対する要求が高度化する中で,各子部品が個別の要求を満たしていても,それらの組合せによる微妙な相性により,組立後の製品が要求を満たせない場合がある.一方,子部品の加工精度には限界があり,形状や特性に関する一定の製造ばらつきは許容せざるを得ない.こうした背景から,低コストで機能要求を満たす製品を安定して生産する技術が希求されている.
近年,こうした問題に対し,選択組立 ( selective assembly ) と呼ばれる,ロット内の子部品ばらつきを考慮して,組立後の製品の品質を向上させる手法が広く検討されている.例えば山田 ( 1 )は,ロット内の子部品の特性情報を参照し,それらの差のばらつきを低減しながら残留部品の発生を低減する選択組立法を提案している.しかしながら,先行研究の多くは寸法差など,子部品の特性のばらつきにのみ注目しており,それらが組立後の製品の品質判定にどのように関わるかについては直接扱うことができない.
そこで本研究では,ロット内の子部品同士を組み合わせる際に,過去の製造データから学習した不合格確率モデルを用いて,実際の合否判定に直結するリスクを定量化し,ハンガリアン法 ( 2 )による最適割当問題のコストとして組み込むことを提案する.具体的には,子部品AとBの組合せ特徴量から不合格確率を推定し,それをコスト行列に反映することで,合格品数を最大化するマッチングを効率良く探索できるように設計する.また,ベイズ最適化 ( 3 )で用いられる不確実性の考慮を応用し,モデル誤差や未知のばらつき要因にも柔軟に対応できるコスト関数を設定する.本手法により,従来の寸法差に基づく最適化だけでは捉えきれない品質判定の視点を組合せ戦略に導入し,多様化する製造工程における不合格リスクを低減することを目的とする.
2. 問題設定
本稿では,二つの異なる子部品AとBを組み合わせて製品を生産する際の最適なマッチングアルゴリズムを検討する.
具体的にはロット内に子部品Aがn 個,子部品Bがm 個存在し,それぞれに特徴量ベクトルai ( i = 1, ..., n ),bj ( j = 1, ..., m ) が与えられている状況を考える.これらの特徴量は,各子部品の品質や特性を数値化したものである.
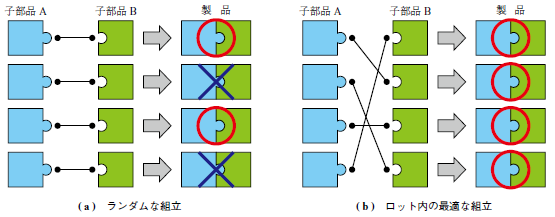
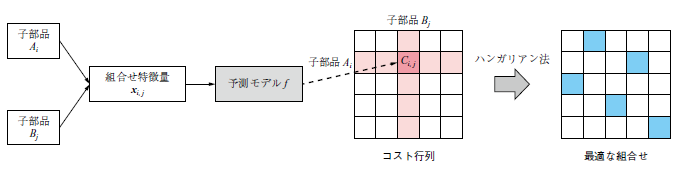
目標は,これらの特徴量を用いて子部品の組合せを最適化し,ロットから生産される製品の合格品数を最大化する,すなわち,不合格品数を最小化することである.第1図に本研究における問題設定を示す.
具体的には,以下の数式で表されるロット内の不合格品数の期待値を最小化することを目指す.
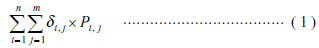
ここで,δi, jは子部品Aiと子部品Bjを組み合わせる場合に1となり,それ以外は0となるバイナリ変数であり,Pi, jは子部品Aiと子部品Bjの組合せにおける未知の不合格確率を表す.
問題設定においては,以下の制約条件を考慮する.
・ 各子部品は一度だけ使用される
・ 合計でmin (n, m) 個の製品が生産される
この条件の下で,最適な組合せを見つけることを目的とする.3章では,この問題を解決する具体的な手法を提案する.
3. 提案手法
ロット内の子部品の組合せを最適化するための手法を説明する.
3.1 マッチング最適化
2章で述べた問題は,最適割当問題として定式化できる.特に,コスト行列Cを用いた最適割当問題では,ハンガリアン法により最適なマッチングを効率的に探索できることが知られている.与えられたk × kの子部品の組合せに対して,適切なコスト行列Cが用意されている場合,ハンガリアン法を適用することで,行と列の間での最小コストのマッチングをO(k3)で探索できる.ここで,コスト行列Cの各要素Ci, jは,子部品Aiと子部品Bjの組合せにおける不合格確率Pi, jを反映した値である.
ハンガリアン法は通常,正方行列に対して適用されるが,ロット内の子部品の数が異なる場合( n ≠ m )でも,少数の子部品について,どの相手とも十分大きく等しいコストを持つダミーの子部品を追加することで適用が可能となることが知られている.
3.2 分類モデルの構築とコストの設定
子部品のマッチング最適化にハンガリアン法を適用するには,ロット内のすべての組合せに対して適切なコストCi, jを設定する必要がある.製品の合格確率を考慮した最適な組合せを検討する際,最も単純なコストとして,過去の子部品の組合せとその合否結果に基づいて2値分類モデルを構築し,各組合せに対する予測確率を用いることが考えられる.具体的には,子部品Aiの特徴量ベクトルaiと子部品Bjの特徴量ベクトルbjおよび適当な関数hを用いて,組合せに対応する特徴量ベクトルxi, j = h(ai, bj)を生成し,分類モデルによる組合せの不合格確率の予測値 をコストCi, jとして用いる方法である.ここで,組合せ特徴量は,単にベクトルを連結したものや,特定の関数を適用したものが利用可能である.
また,予測の不確実性も考慮したコストを設定することで,不合格確率が大きく変動するような組合せを回避し,歩留まりの向上だけでなく,製造プロセス全体の信頼性の向上への寄与も期待できる.さらに,予測モデルの精度が完全でない場合,例えば,データ不足や未知の要因の影響がある場合には,不確実性を適切に評価することで,モデルの限界に起因する問題を緩和できる可能性がある.こうした観点から,本研究では予測の不確実性を考慮するために,組合せに対する複数のコストCi, jを考え,比較,考察を行う.
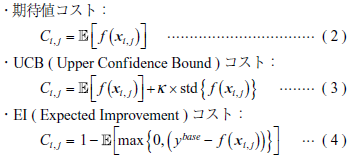
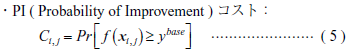
ここで,fは予測の不確実性を考慮できる2 値分類モデルであり,本研究ではガウス過程分類器 ( Gaussian Process Classification:GPC ) を利用する.UCB,EI,PIコストは,ベイズ最適化における同名の獲得関数に着想を得たものである.ただし,本研究で用いるGPCでは,潜在関数に対してプロビット関数をリンク関数として適用することで不合格確率を求めているため,UCBコストは確率空間での事後平均と標準偏差を用いて定義している.UCBにおけるκは,平均に対する標準偏差の重み付け係数であり,探索と活用のバランスを調整するパラメータである.この値を大きくすると不確実性を重視して探索的な選択を促し,小さくすると平均値を重視した選択となる.また,EIコスト,PIコストにおけるybaseは,ベイズ最適化のEI,PIで用いられる暫定の最適値とは異なり,基準となる不合格確率を表し,過去の実績などから設定する.なお,UCBやEIコストの計算には,モンテカルロサンプリングによる近似計算を用いる.
3. 3 提案手法の全体像
本研究における提案手法の全体像を第2図に示す.図に示すとおり,まず子部品AiとBjの特徴量aiとbjから組合せ特徴量xi, jを生成し,予測モデルfによって3. 2節で説明したコストを算出する.次に,得られたコストをコスト行列として整理し,ハンガリアン法により全体の組合せを最適化する.
4. 実験設定
提案手法の有効性を検証するため,合成データを用いて実験を行う.
4.1 シミュレータの設計
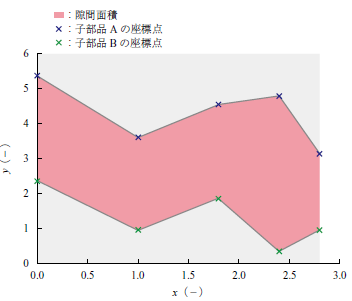
実験においては,子部品の組合せに対する不合格確率を評価するため,特定のシミュレータを設計する.第3図にシミュレータのイメージを示す.具体的には,以下の設定を用いる.
- (1)子部品の生成
- 子部品AおよびBに対して,それぞれ5 か所の座標点を生成する.各座標点は二次元(x, y)で表され,x 座標は固定値とし,y 座標のみランダムに決定する.これらの座標情報を,子部品Aの特徴量ベクトルai,子部品Bの特徴量ベクトルbjとする.
- (2)不合格確率の計算
- 子部品AとBの寸法間に形成される面積を「隙間面積」と定義し(第3図),この面積に基づいて不合格確率を設定する.具体的には,シグモイド関数を用いて,隙間面積が大きいほど不合格確率が高くなるようにモデル化する.
4.2 実験方法
本実験では,提案手法の有効性を評価するため,以下の方法で実験を行う.
- 学習データの生成:
- シミュレータを用いて子部品A,BをN 対生成し,それらをランダムに組み合わせた製品に対して計算される不合格確率に基づき合否のラベルを与える.
- 分類モデルの構築:
- 生成した学習データに対してGPCを適用する.ただし,今回は組合せ特徴量として,子部品寸法を単純に結合した特徴量を利用し,xi, j = {ai, bj}とする.
- テストデータに対する適用:
- テストデータとしてn 対の子部品を用意し,それらのn × nの組合せに対して3. 2 節の各コストを計算し,ハンガリアン法による最適化を実施する.ただし,UCBコストではκ= 1,EIコスト,PIコストではy base = 0.5とする.さらに,ランダムな組合せとの比較を行い,提案手法の有効性を評価する.評価は,シミュレータによって計算される真の不合格確率を用いて ( 1 ) 式により行う.
5. 実験結果
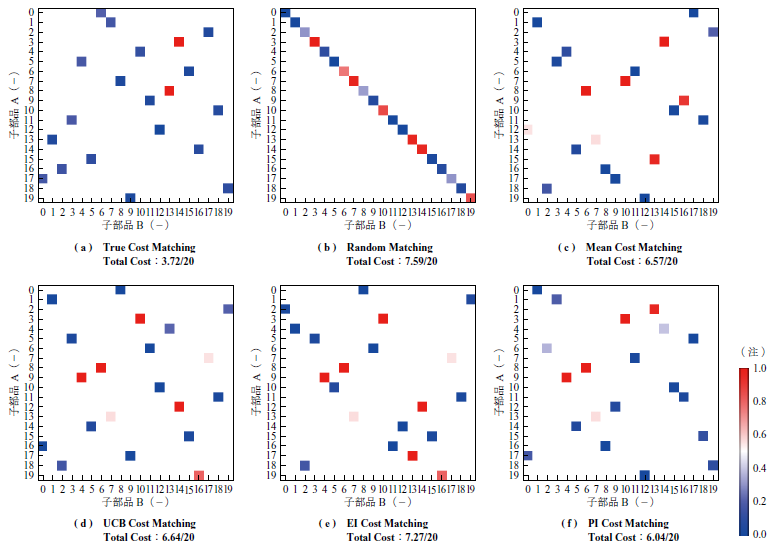
第4図に単一ロットに対する提案手法の評価を示す.これは,提案手法を含む各手法により,20 対の子部品を含む1 ロットに対して組合せを行い評価したものである.ここでは学習データ数を100 件とした.各手法が選択した組合せに基づく ( 1 ) 式の評価指標を「Total Cost」としてそれぞれ表示しており,これは20 個の製品のうち不合格となる数の期待値を表す.また,各マトリックスのセルは組合せに対する真の不合格確率をカラースケールで示しており,青は値が0.0に近いことを,赤は値が1.0に近いことを表す.「True Cost Matching」として示される結果(第4図 - ( a ))は,真の不合格確率が既知であると仮定し,ハンガリアン法を用いて得られた理想的なマッチングの結果( 3.72/20 )を表している.一方,第4図 - ( b )の「Random Matching」はランダムに組合せを選択した場合の結果であり,他手法と比較して高い値 ( 7.59/20 ) を示していることから,無作為な選択が効率的でないことが明らかである.期待値,UCB,EI,PIといったコストを用いたマッチングを比較すると,PIが最も理想に近い結果 ( 6.04/20 ) となった.
さらにロット数を増やした際の結果を第5図に示す.図は学習データの数を50,100,200とした際の結果であり,提案手法における各コストを用いた組合せがランダムな組合せと比較して平均的にどれだけ不合格品数を減らせるかを評価したものである.どのコストによる組合せも約半分が不合格となるランダムな組合せ(青線)よりも効果があり,また,学習データが増加すると最適な組合せ(破線)に近づく傾向が確認できるが,今回の設定ではPIが最も理想に近い結果となった.
6. 考察
ベイズ最適化では,次に評価する点を選ぶために,探索と活用のバランスを考慮した獲得関数を用いる.このうち,UCBやEIは,未知領域の情報を積極的に取得して最終的な精度向上を図る探索の要素が比較的強い.一方,PIは,UCBやEIよりも活用に重点を置く性質があるため,本研究のように一度の学習で最適な組合せを求める静的な問題設定には適していたことが考えられる.すなわち,逐次的に学習して未知領域を探索する必要がないため,合格確率が一定のしきい値を超える組合せを優先選択するPIが,UCBやEIよりも低リスクに多くの合格品を得る戦略と合致した可能性がある.また,単に期待値のみを用いるコストでは不確実性を加味しないため,学習データが限られる場合では精度への不安が残るが,PIはモデルの分散情報を組み込みつつ基準しきい値を上回る可能性を高めることができるため,本研究でより良い成果を示したと考えられる.
7. 結言
本研究では,ロット内の異なる子部品AとBを組み合わせて製品を生産する際に,より多くの合格品を得るための最適な組合せを探索するためのアルゴリズムを提案した.提案手法は,過去の製造データから子部品の組合せに基づいて製品の不合格確率を予測するモデルを構築し,その予測を基に最適な組合せを探索する.特に,ベイズ最適化における獲得関数に着想を得た予測の不確実性を考慮したコストを設計し,ハンガリアン法による組合せ最適化に応用した.
シミュレーションによる実験結果から,提案手法はランダムな組合せと比較して,ロット内の不合格品数を大幅に減少させることが確認できた.特に,PIコストを用いたマッチング戦略が最も優れた成果を示し,実際の製造プロセスにおいても有用である可能性が示唆された.
また,今回は過去データからロット内の組合せを最適化する静的な問題設定であったが,ベイズ最適化のように逐次的に学習を行うことで,リアルタイムでの最適化精度の向上が期待される.そのようなアルゴリズムの検証は今後の課題である.また,実務的には学習したモデルから製造プロセスへのフィードバックを行う方法の開発も重要である.具体的には,モデルの予測結果や学習結果をどのように製造現場に還元し,製品品質や生産効率の向上に役立てるかを検討する必要がある.さらに,より複雑な製造プロセスに対応するため,提案手法を三つ以上の子部品のマッチングへ拡張することも検討していきたい.
本研究の成果は,製造業の効率化と信頼性向上に貢献するものであり,今後さらなる研究と応用を進めていく予定である.
参考文献
(1) 山田泰弘:連続生産の選択組立における組合せ最適化,日本機械学会論文集C 編,60 巻,573 号,1994 年,pp. 1,877-1,881
(2) H. W. Kuhn:The Hungarian method for the assignment problem,Naval Research Logistics Quarterly,Vol. 2,Iss. 1-2,( 1955 ),pp. 83-97
(3) B. Shahriari, K. Swersky, Z. Wang, R. P. Adams and N. de Freitas:Taking the Human Out of the Loop: A Review of Bayesian Optimization,Proceedings of the IEEE,Vol. 104,Iss. 1,( 2016 ),pp. 148-175
(4) 大久保叡一,青山紘己,川口明敬,鈴木由宇,河野幸弘:製品の合格確率を考慮した子部品マッチングアルゴリズムの提案,人工知能学会全国大会論文集,JSAI2025 巻,第39回,2025年 ( 「2025年度人工知能学会全国大会」で発表した論文 ( 4 )の内容を加筆修正)